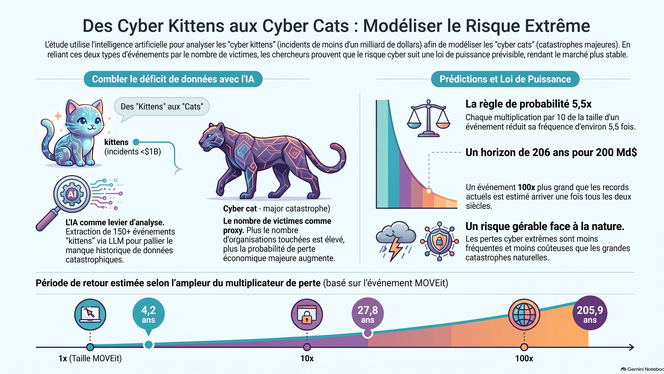
La rareté des données empiriques sur les méga-catastrophes cyber (Cyber Cats > 1 Smilliard) rend leur modélisation complexe. Pour y remédier, une méthodologie s'appuie sur le classement par LLM de réclamations d'assurance pour analyser les Cyber Kittens : des événements systémiques de moindre ampleur.
L'étude démontre que ces événements suivent une loi de puissance (coefficient α=1,74), utilisant le nombre de victimes pondéré comme indicateur de perte. Cette approche permet de quantifier la fréquence des événements extrêmes (Gray Swans) : un sinistre de 20 milliards de dollars présente une période de retour de 28 ans, contre 206 ans pour 200 milliards.
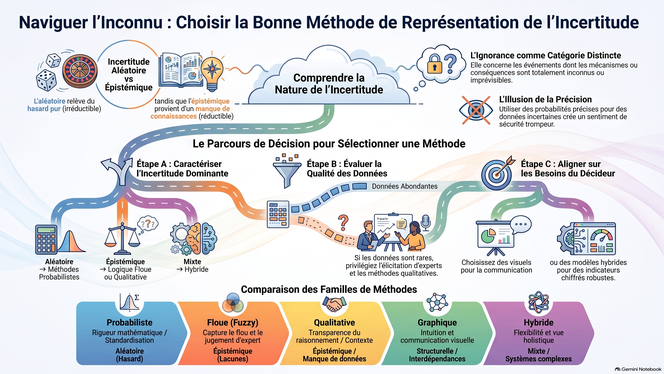
Face à des risques systémiques complexes, traiter l’incertitude de manière simpliste génère une « précision fallacieuse ». Pour bâtir des analyses de risques robustes et auditables, ce cadre propose de catégoriser d'abord la nature de l'incertitude en distinguant l'aléatoire (variabilité intrinsèque) de l'épistémique (manque de connaissances), tout en prenant en compte l'ambiguïté et l'ignorance. Il s'appuie sur cinq familles méthodologiques — probabilistes, floues/d'évidence, qualitatives, graphiques et hybrides — dont le choix s'effectue via un parcours décisionnel en cinq étapes fondé sur la qualité des données et les besoins de gouvernance. Une checklist de documentation valide l'approche finale pour transformer la fragilité des connaissances en décisions résilientes.
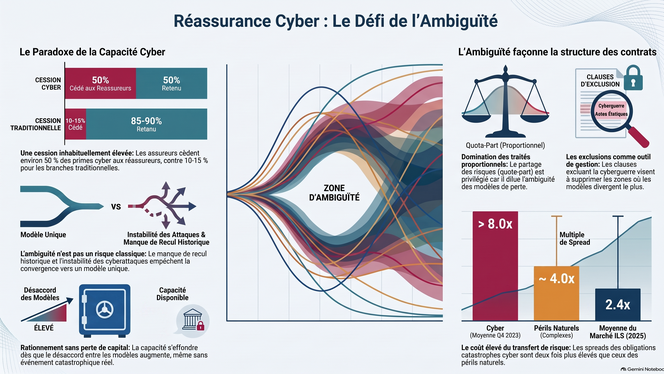
Selon l'article, le marché de la réassurance cyber ne souffrirait pas d'un manque de capital, mais plutôt d'une forme d'ambiguïté découlant de l'absence d'un modèle probabiliste unique pour évaluer le risque systémique. L'auteur souligne que, face à des modèles divergents, les réassureurs adopteraient une posture pessimiste en surpondérant les scénarios les plus sombres, ce qui provoquerait une surcharge tarifaire et un rationnement de l'offre.
Pour contourner ce frein, l'article indique que le marché privilégierait les traités en quote-part, susceptibles de diluer l'incertitude, tout en affinant le langage contractuel grâce à des exclusions claires. Selon la publication, seules la standardisation des données et la convergence des modèles permettront, à terme, de libérer pleinement la capacité de réassurance.
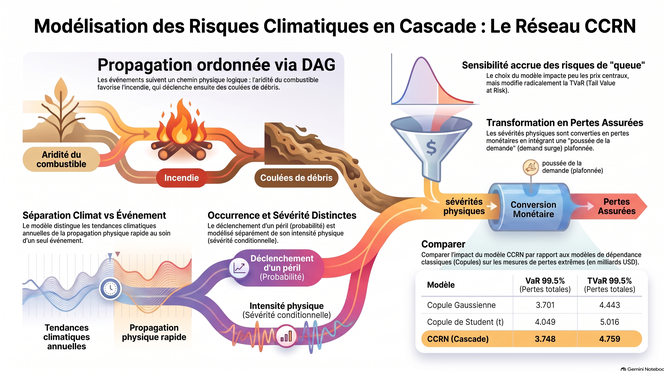
Le modèle Cascading Climate Risk Network (CCRN) surmonte les limites des copules statiques en modélisant la propagation causale des risques climatiques via des Graphes Acycliques Dirigés (DAG). Il dissocie le conditionnement climatique annuel de la cascade physique intra-événementielle. Cette approche offre une transparence causale sur les enchaînements d'aléas (ex. : aridité → incendie → coulée de débris), une précision accrue sur les pertes extrêmes (VaR et TVaR à 99,5 %) pour la tarification des tranches hautes de réassurance, et une robustesse théorique fondée sur la monotonie, essentielle au stress-testing réglementaire et à la gestion du capital.
Le secteur européen de l'assurance conserve une résilience globale avec un niveau de risque maintenu à « médium », porté par une solide solvabilité (groupes à 210 %) et la haute qualité de ses fonds propres (86 % en Tier 1).
Toutefois, le risque lié à la numérisation et aux menaces cyber a été relevé à « Élevé » en raison de l'IA de pointe, de la complexité de la souscription cyber et de la hausse des attaques. L'environnement macroéconomique s'assombrit sous l'effet d'une croissance atone (1,0 %) et d'une inflation en hausse (2,9 %), imposant une vigilance accrue à long terme.
L’évaluation des risques environnementaux nécessite une rigueur quantitative pour surmonter l’opacité du marché. La VaR classique étant inadaptée aux ruptures systémiques, l’Expected Shortfall et le « Coût du risque environnemental » offrent un cadre prospectif plus robuste. Entre l’approche macroéconomique (Top-down) et la démarche granulaire par site (Bottom-up), cette dernière reste l'objectif clé pour la gestion de portefeuille. Une modélisation fiable exige sept principes : transparence, géolocalisation des actifs, priorité aux données observables pour limiter la propagation d'erreurs, prise en compte des interactions non linéaires, scénarios prospectifs, agrégation cohérente et adéquation aux besoins de l'utilisateur. Ces principes garantissent des décisions auditables et actionnables.
Ce document de l'ACPR analyse l'impact de l'instabilité climatique sur le secteur de l'assurance non-vie en France entre 2021 et 2024. Face à l'augmentation de la fréquence et de la gravité des sinistres naturels, les assureurs adaptent leurs stratégies de tarification et leurs méthodes de provisionnement technique. L'étude souligne l'utilisation croissante d'outils de géolocalisation précis et de zoniers pour segmenter les risques et ajuster les primes. Les entreprises renforcent également leur gouvernance interne en intégrant des scénarios climatiques à long terme dans leur gestion des risques. Enfin, bien que la prévention auprès des assurés soit identifiée comme un levier essentiel, elle reste encore insuffisamment exploitée.
Cet article redéfinit le partage multilatéral des risques en assurance, où un assureur mutualise les risques de n agents. Face aux limites du modèle de Pareto classique — qui tolère l'exclusion d'agents et masque la dégradation de situations individuelles en raison de prix endogènes couplés —, les auteurs introduisent l'optimalité de Pareto inclusive et équitable (iFPO). Fondée sur des matrices séquentielles liées à des partitions d'ensembles ordonnées, cette méthodologie convexe garantit que chaque participant pèse mathématiquement dans l'optimisation. Testé via l'Expected Shortfall, l'iFPO s'impose comme un outil de gouvernance transparent et auditable pour la gestion des risques.
Cet article, basé sur une prépublication qui propose un cadre de partage de risque cyber P2P entre entreprises interconnectées. Les auteurs distinguent un réseau d'attaque, générant la dépendance des pertes par contagion, d'un réseau de partage, allouant les charges réalisées. La perte de chaque sinistré est décomposée en attribution causale, rétention propre et mutualisation résiduelle.
Cet article examine la « propriété d’équilibre » dans les modèles statistiques utilisés pour la tarification en assurance, selon laquelle le montant total des primes estimées doit correspondre au montant total des sinistres observés dans l’échantillon. Il compare trois méthodes permettant de rétablir cette propriété lorsque les modèles GLM à liens non canoniques ne la respectent pas. L’auteur montre que l’estimation sous contrainte (SC) offre de meilleures performances asymptotiques que les approches de quasi-vraisemblance (QMLE) et de post-traitement simple (SPP). L’étude établit également un lien entre cette propriété d’équilibre et les mécanismes de partage des risques ex post.